 ECAI LABOEC自動化の実験室
AI のモデル写真は本物に見えるのか。
148人に伏せて聞いた
商品ページのモデル写真を、AI で作れないか試しています。実写17枚と AI 画像42枚を混ぜて、148人に1枚ずつ「写真か AI か」を当ててもらいました。決め手は「顔」でした。
実在の人を参照にした AI は、実写と同じくらい本物と判定された
本物の写真と判定された割合。実写でも4割近くは AI と思われた。
実写との差は誤差の幅に収まる。
多くの人に見抜かれた。
- 人は、ほぼ当てずっぽうだった。AI 画像を AI と当てた割合は平均 51.9%。「自信がある」と答えても、AI 画像での正解率は 56.1% でした。
- 当たる決め手は顔。背景は疑うきっかけにしかならない。「全体が整いすぎ」で AI と判断したときは 74.2%、「顔立ち・表情」は 64.0% 当たりました。「背景とのなじみ」は 53.8% で、実写を AI と間違えた理由の1位でもありました。
- AI 画像で不利な条件がはっきり出た。背景にほかの人が写る(26.2%)、歯を見せて大きく笑う(34.0%)、全身が写る(40.9%)。足元や靴の1か所の違和感でも、全体が AI に見えます。
- 実写でも、明るすぎる写真は AI と判定された。実写17枚では、白く飛んだ部分が多い写真ほど本物と判定されにくい関係でした(順位の相関 −0.83)。
- 合格の目安を変えた。「100% 本物と判定されること」ではなく、「実写と同じ割合で本物と判定されること」を目指します。
このページの画像について。調査で使った実写と、実在の人を参照にした AI 画像は載せていません。写っている人物はすべて、説明のために新しく AI で作った架空の人物です。グラフの数字は調査の集計そのままです。
撮影に頼らずに、実写と同じ品質の商品ページを作りたい
撮影は、モデルさん・カメラマン・場所の手配で、毎回まとまった費用と日数がかかります。AI で同じ品質のモデル写真が作れるなら、新商品を出す速さが変わります。
ただ、自分で見て「本物っぽい」と思っても当てになりません。そこで、人が「AI だ」と感じる点と「本物の写真だ」と感じる点の境目をはっきりさせることにしました。分かった条件は、画像の作り方の手順と、出来上がった画像を点検する道具の両方に使います。
きっかけは、AI に比べさせる方法だった
YouTube で見た方法がきっかけです。良いものと AI の生成物を、どちらがどちらか伏せて AI に渡し、違いを項目ごとに言わせる。自分では気づけない違和感が言葉になる、という話でした。
まずこれをそのまま試しました。自社のスタジオで撮った実写4枚と AI 画像4枚を組にして、Claude と Codex に計16回比べさせると、16回とも実写の側を本物と当てました。でも、使った AI 画像は私が見ても一目で AI と分かるものでした。AI が挙げる理由はもっともらしく聞こえても、それが人の判断を左右しているかは別の話です。お客様が本物と思うかどうかは、人に聞くしかありません。
配信前に、予想を書き残した
回答を集める前に、私と Claude で結果の予想を書き、後から直さない決まりにしました。私が自分で試し回答をしたときの所見も、仮説として並べています。
| 配信前の予想・仮説 | 予想 | 結果 | 判定 |
|---|---|---|---|
| 窓の光の室内で撮った実写は、どれくらい本物と判定されるか | Claude 85% ヨシ 60% | 55.7% | ヨシが近い |
| スタジオで撮った実写 | Claude 85% | 77.4% | やや高すぎ |
| 背景を強くぼかした屋外の実写 | Claude 55% ヨシ 45% | 56.5% | Claude が近い |
| 明らかな AI(基準の3枚) | Claude 15% ヨシ 5% | 14.0% | Claude が近い |
| 実在の人を参照にした AI(Codex) | Claude 45〜60% ヨシ 60% | 62.7% | ヨシが近い |
| 実在の人を参照にした AI(Google 側) | Claude 35〜40% ヨシ 45% | 61.4% | 2人とも低すぎ |
| Codex で作った方が Google 側より本物と判定される(Claude) | ― | 62.7% 対 61.4% | 差はほぼない |
| 背景を強くぼかした画像は本物と判定されにくい(Claude) | ― | 60.9% → 44.4% | 当たり(AI では) |
| 顔と肌がきれいすぎると AI っぽい(ヨシの試し回答) | ― | 架空 34.5% | 当たり |
| 1か所でも本物らしくない部分があると、全体が AI に見える(ヨシの試し回答) | ― | 「その他」74件中23件が足・靴 | 当たり |
| 人物と背景のボケ・明るさの差が大きすぎると AI っぽい(ヨシの試し回答) | ― | 明るさの差の相関 −0.14 | 背景は手がかりにならない |
「本物と判定された割合」は、その画像を見た人のうち「カメラで撮った写真」と答えた人の割合です。以下すべて同じ指標です。
1人に33枚を見せて、1枚ずつ「写真か AI か」を聞いた
- STEP 1AI に比べさせる実写と AI を伏せて組にし、Claude と Codex に16回比べさせた
- STEP 2自分で試すテスト用のページで私が3回回答。33枚中30・27・28枚正解
- STEP 3組み直す明らかな AI は3枚だけ残し、見分けにくい画像を中心にした
- STEP 4148人に聞くクラウドサービスで募集し、Google フォームで回答してもらった
1人が見た33枚の内訳
赤は明らかな AI(基準の3枚)。見分けにくい AI は、回答者を生まれ月で3組に分けて組ごとに入れ替えたので、全体では39枚。1枚あたり約50人が見ています。
| 回答者 | クラウドサービスで150件を募集。写真を見ずに33枚すべて同じ答えにした1件と、同じ人の2回目1件を除いた148人を集計。女性75・男性68・回答しない5。30〜50代が中心(20代9・30代35・40代59・50代30・60代以上15) |
|---|---|
| 聞いたこと | 1枚ごとに「カメラで撮った写真か、AI で作った画像か」「自信の強さ(自信がある・たぶん・当てずっぽう)」「決め手(複数選択・その他は自由記入)」 |
| 実写 17枚 | 過去に撮った3回分の撮影から選んだ。スタジオ6枚・窓の光の室内6枚・背景を強くぼかした屋外5枚。服はすべて自社の同じアパレル商品 |
| AI 画像 42枚 | 実在のモデルさんの写真を参照にしたもの30枚(社内テストとして作成)・実在しない架空のモデル9枚・明らかな AI の基準3枚。作った道具は Codex 29枚・Google の Nano Banana 13枚(Antigravity 8枚・Gemini API 5枚) |
| そろえたこと | すべて同じ大きさ(800×1200)の JPEG にし、撮影情報を消し、中身の分からない番号を付けた |
| 費用 | 単価25円(税込27円)で150件を募集し、3,750円を仮払いした |
実写と、実在の人を参照にした AI の差は 1.3 ポイントだった
架空のモデルは 34.5%、明らかな AI は 14.0%。AI が全部見分けられないわけではありません。
線の幅は「この範囲のどこかに本当の値がある見込み」を表す95%の幅です。実写(61.7〜65.5%)と実在の人を参照にした AI(59.8〜64.7%)は大きく重なっていて、差があるとは言えません。
同じ人の実写と AI を、撮影ごとに並べる
スタジオ風の AI は 82.7% で、同じスタジオの実写の 77.4% を数字では上回りました。ただ、95%の幅が重なるので「実写以上」ではなく「実写と同じくらい」と読んでいます。撮影ごとに見ても、実写が高い撮影は AI も高く、実写が低い撮影は AI も低い。差は撮影の条件の側にありました。
実写の平均(63.6%)より本物と判定された AI は17枚あり、そのうち16枚が実在の人を参照にした画像でした。架空のモデルは1枚だけです。
正解率は平均 57.9%。AI 画像だけなら 51.9% で、コイン投げに近い
最低 33.3%・最高 78.8%。偶然なら 50%。
二項検定(片側5%)で、当てずっぽうでは出にくい正解数だった人。
フライスのカッパ。0.2 以下は「わずかに一致」。
1人ごとの正解率の分布
33枚中の正解の割合で148人を分けた人数。60〜69% がいちばん多く、70% を超えた人は12人だけでした。
自信は、当たりにつながっていなかった
AI 画像に「自信がある」と答えたときの正解率は 56.1%、「当てずっぽう」は 54.3%。人は、自分が思っているほど AI を見分けられていません。平均すると「写真」と答える方に少し傾いていて(判定の偏り c の平均 +0.20)、見分ける力 d′ の平均は 0.40 でした(0 はまったく見分けられない、1 で「ある程度」)。
当たるのは顔。背景を見た人は外していた
決め手ごとの正解率
その決め手を選んだ判定のうち、当たった割合。緑は 60% 以上、薄い灰は 55% 未満。
「全体が整いすぎ」は、ほぼ「AI だ」と答えるときにだけ選ばれた決め手です(AI と答えたとき 557回、写真と答えたとき 21回)。それで AI と判断したときは 74.2% が当たっていました。感想にも「顔立ちが整い過ぎていて、どれも似ている顔になる」という声がありました。
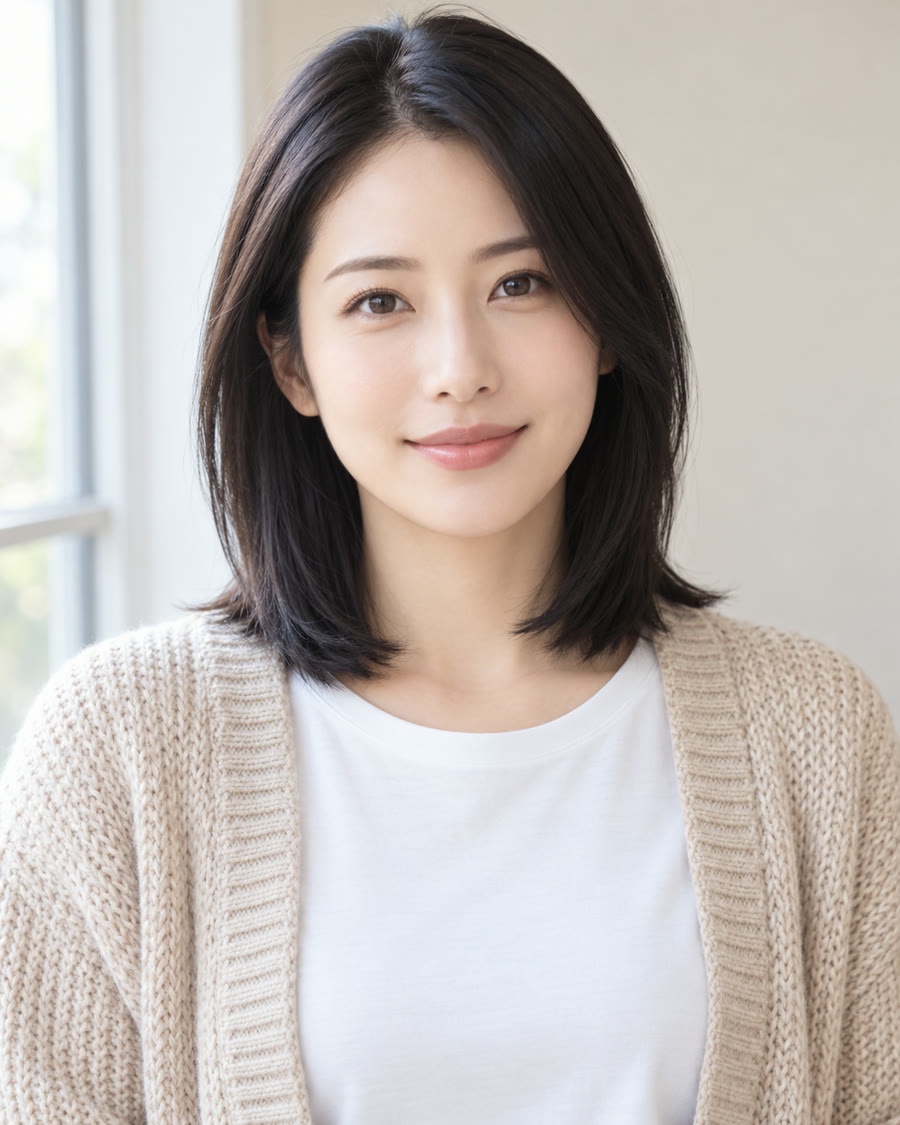
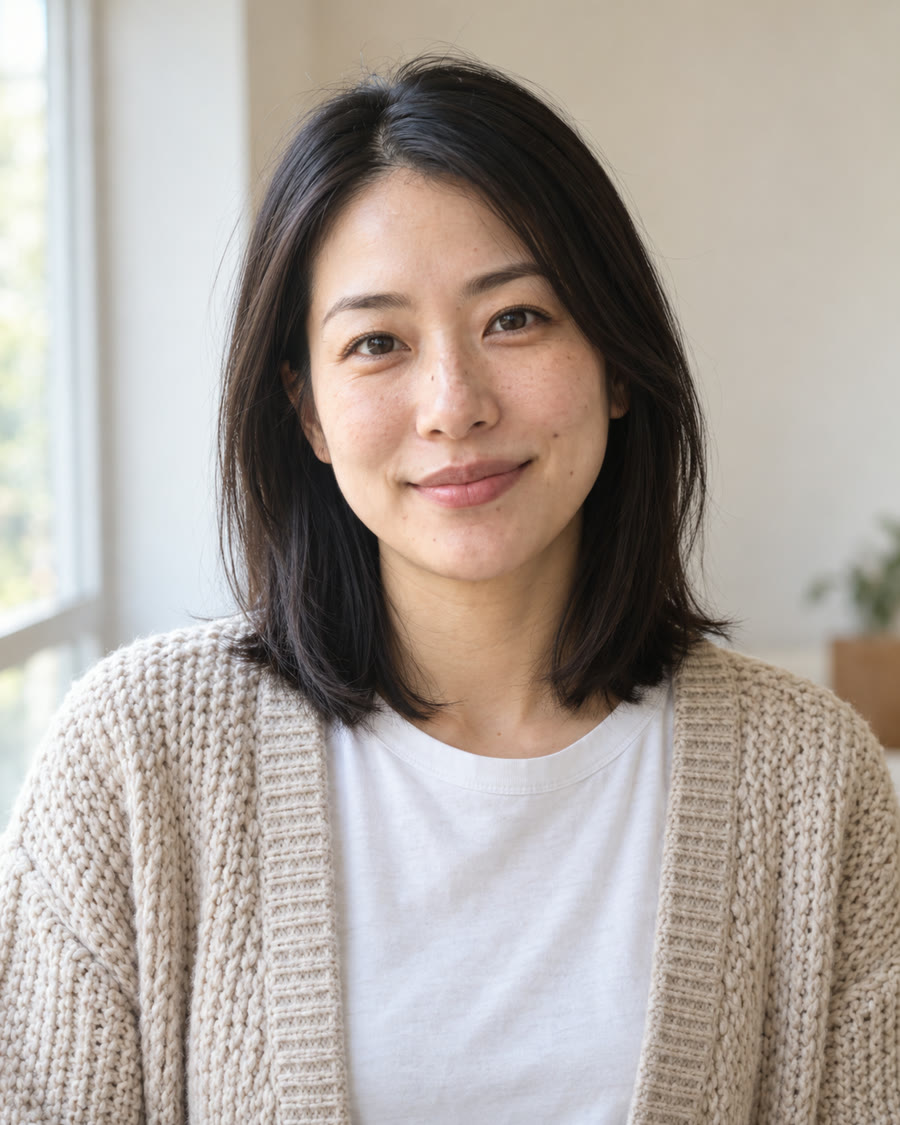
2枚とも説明用に新しく作った同じ架空の人物です。調査の画像ではありません。
よく見分けた人と、見分けられなかった人は、見ている場所が違った
1枚あたり、その決め手を挙げた割合。正解率で148人を4つに分けた、上位と下位の4分の1。
よく見分けた人は「顔立ち・表情」を挙げる割合が 41.8%、見分けられなかった人は「背景とのなじみ」が 33.8% で最多でした。背景は、実写でも AI でも「なじんでいない」と感じやすい場所です。実写を AI と間違えたときの決め手の1位も「背景とのなじみ」(360回)でした。
画像の数値で見ても、人物と背景の明るさの差は、本物と判定される割合とほぼ関係がありませんでした(順位の相関 −0.14)。背景は「AI ではないか」と疑うきっかけにはなっても、見抜く手がかりにはなっていません。
「その他」に書かれたのは、足元だった
決め手の「その他」の自由記入74件のうち、23件が足や靴の違和感でした。スリッパに見える履物、ズボンの幅の左右差、鞄やペンの持ち方。最後の感想49件では、26件が顔や表情に触れていました。
背景の人、大きな笑顔、全身。この3つで本物らしさが落ちた
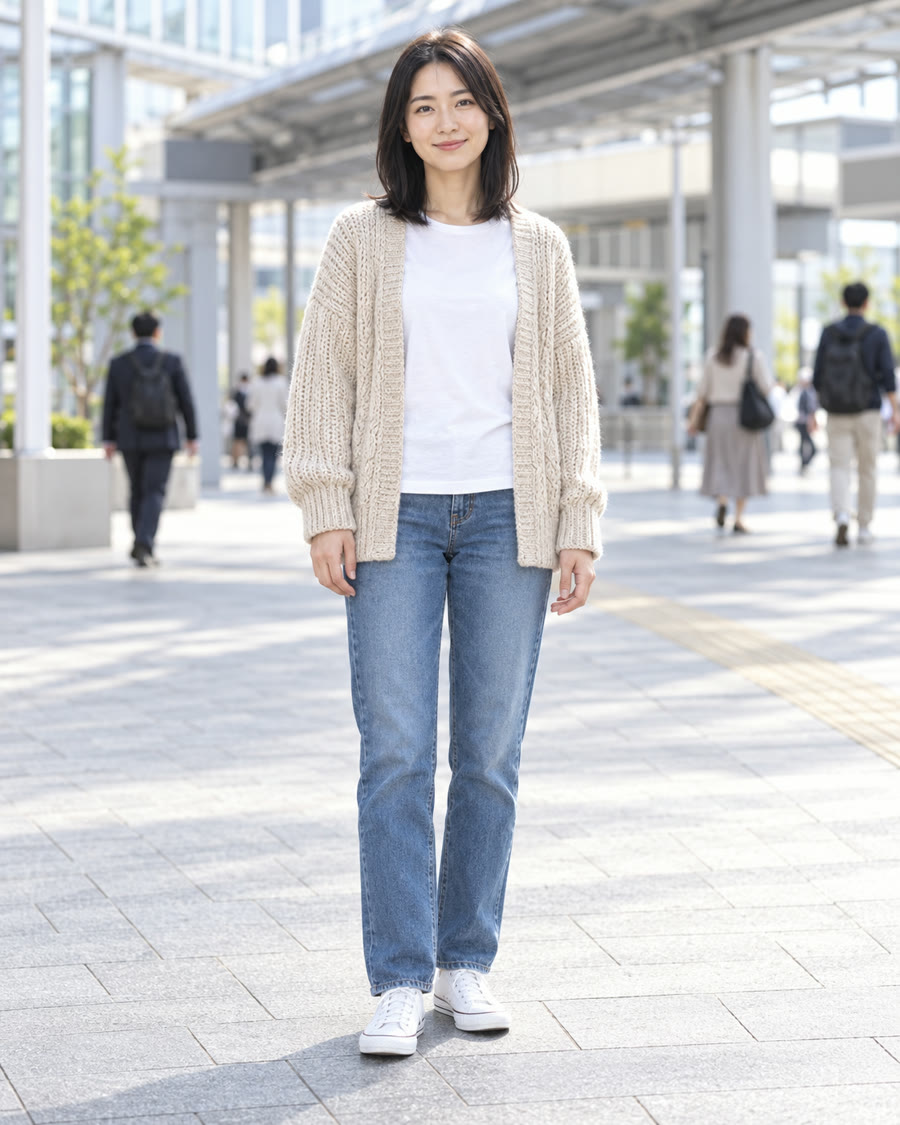
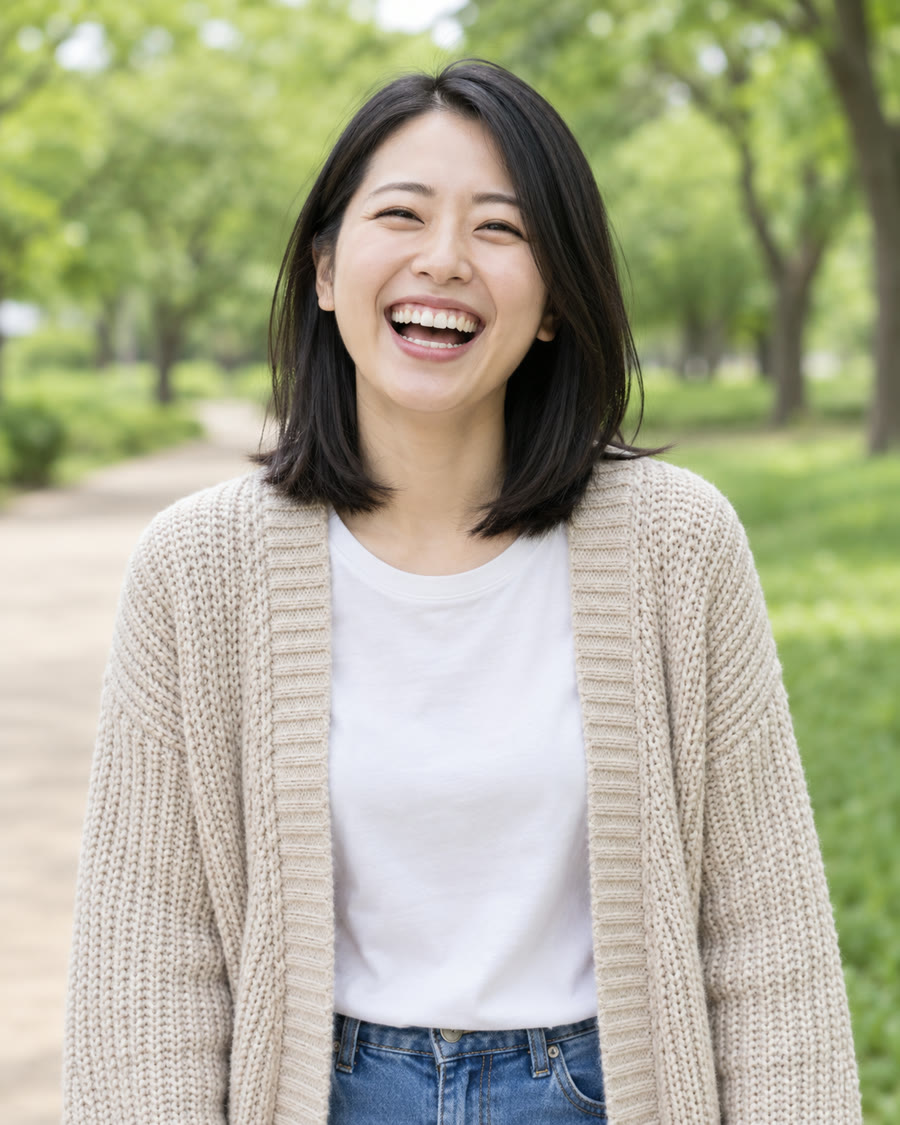
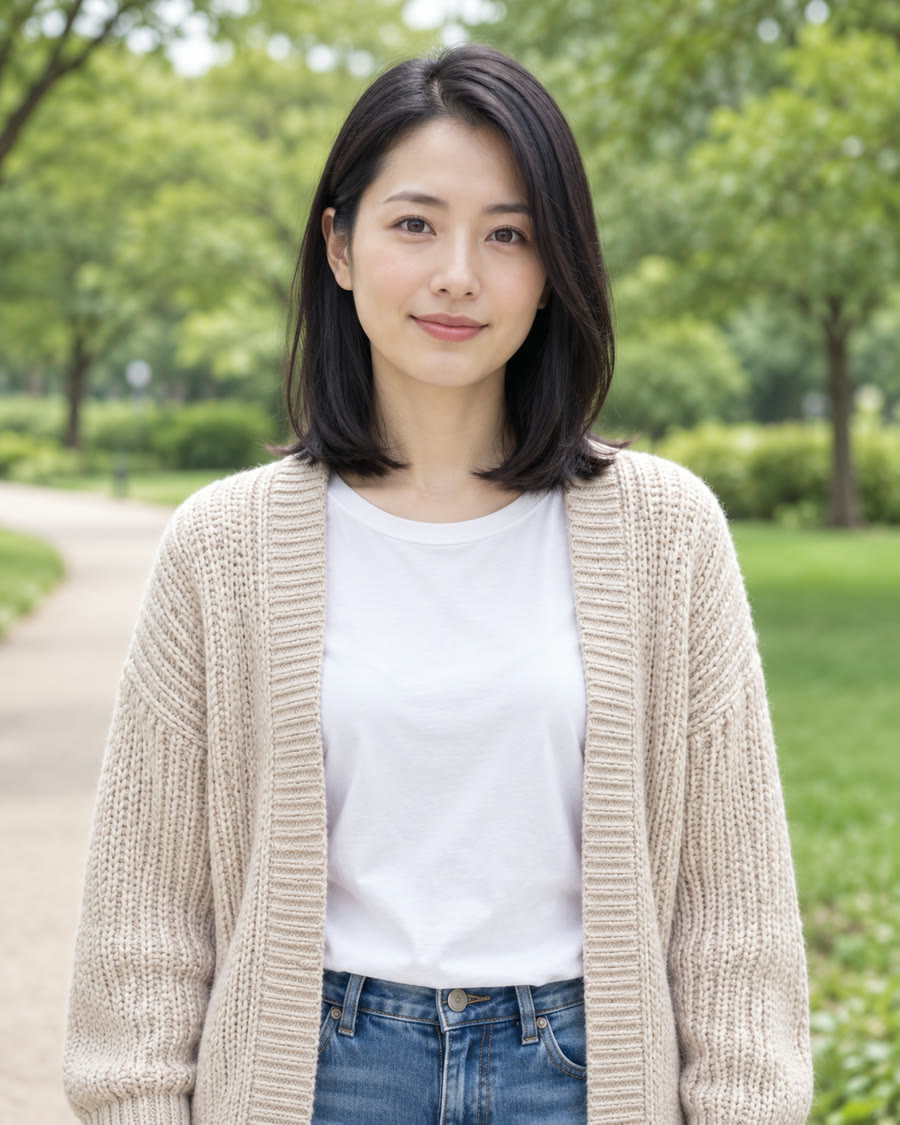
写真はすべて説明用に新しく作った見本で、調査の画像ではありません。
写す範囲が広いほど、不利になった
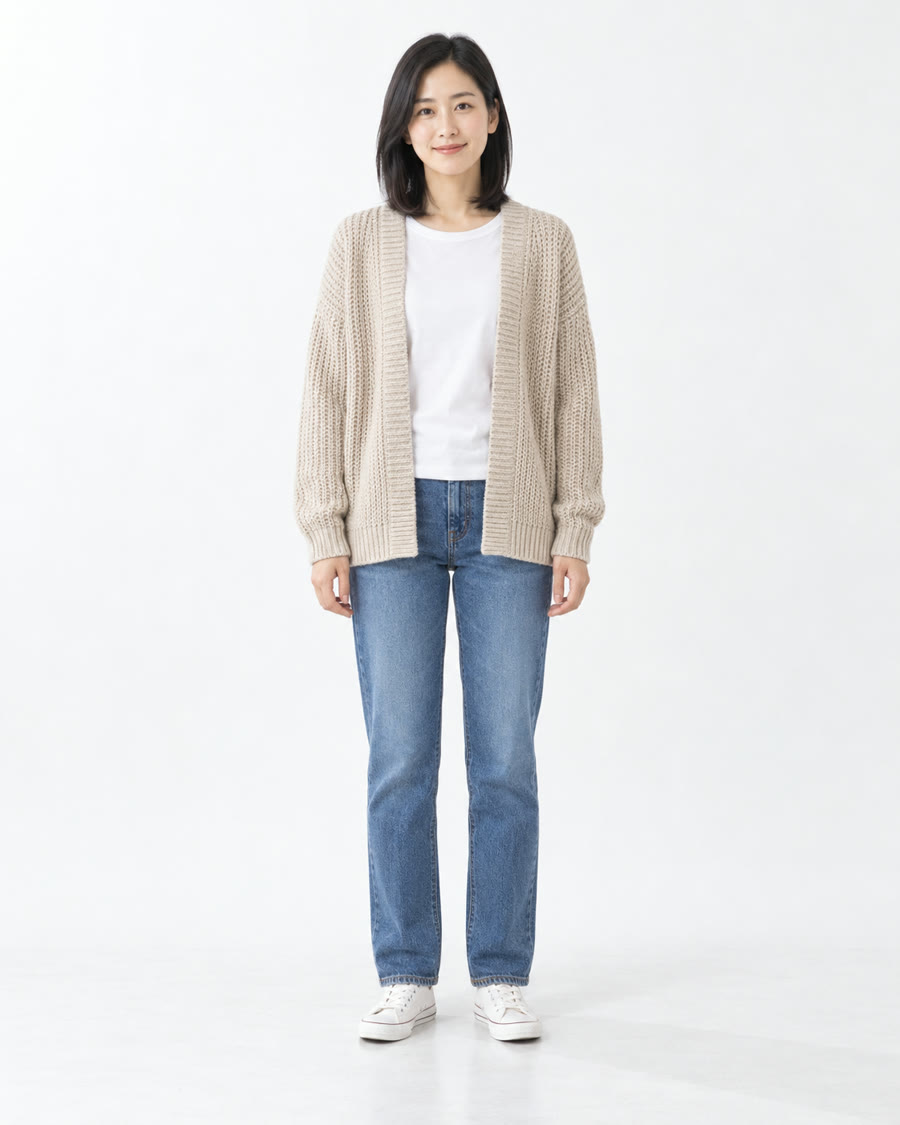
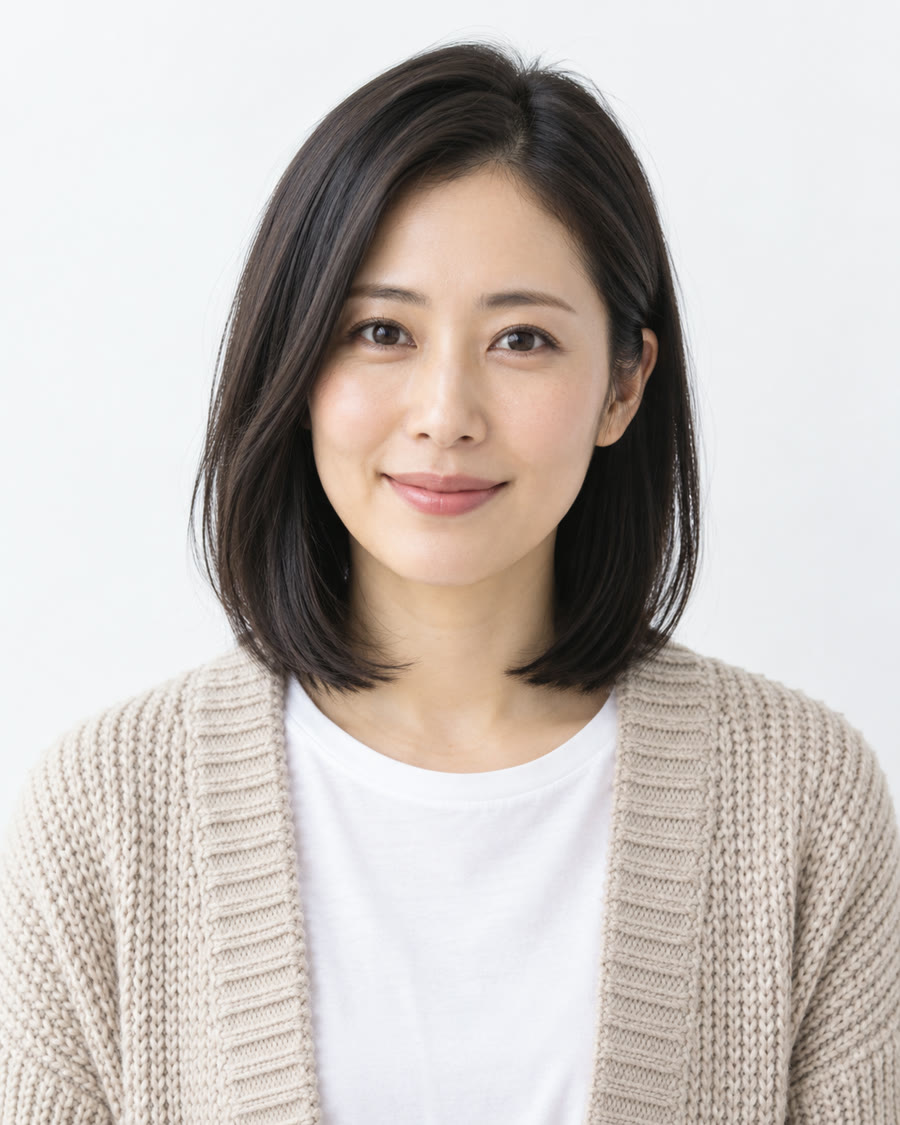
場所は「スタジオ」が有利だった
写真と判定されやすいのは、室内ではなくスタジオでした。実写でもスタジオが 77.4% と高く、窓の光の室内と屋外は 56% 前後です。AI だけでなく、写真そのものの「見慣れた写り方」が効いていると考えています。
背景のぼかしには、ちょうどよい範囲がありそう
同じ全身の構図で背景だけ強くぼかすと、60.9% から 44.4% に下がりました。一方で、画像の数値では、AI は背景までくっきりしているほど AI と判定される傾向もありました(順位の相関 +0.38)。ぼかしは「強すぎても弱すぎても下がる」範囲のある条件とみています。ただし組は1つだけなので、次の回で段階を分けて確かめます。
実写でも、4割近くは AI だと思われた
実写の平均は 63.6% です。つまり本物の写真でも、4割近くは AI と判定されています。実写の中では、明るすぎて白く飛んだ写真ほど AI と判定されました。
| 画像の数値 | 実写17枚 | AI 42枚 |
|---|---|---|
| 白く飛んだ部分の割合 | −0.83 | −0.06 |
| 明るい部分の明るさ | −0.80 | +0.03 |
| 全体の明るさ | −0.74 | +0.14 |
| 人物と背景の鮮明さの比(大きいほど背景がぼけている) | +0.09 | +0.38 |
| 赤み | +0.47 | −0.30 |
| 黒くつぶれた部分の割合 | −0.12 | −0.28 |
| 暗い部分のざらつき | −0.28 | −0.29 |
| 人物と背景の明るさの差 | +0.07 | −0.03 |
数値と「本物と判定された割合」の順位の相関(スピアマン)。マイナスは、その数値が大きいほど本物と判定されにくいこと。太字は偶然とは言いにくい関係。
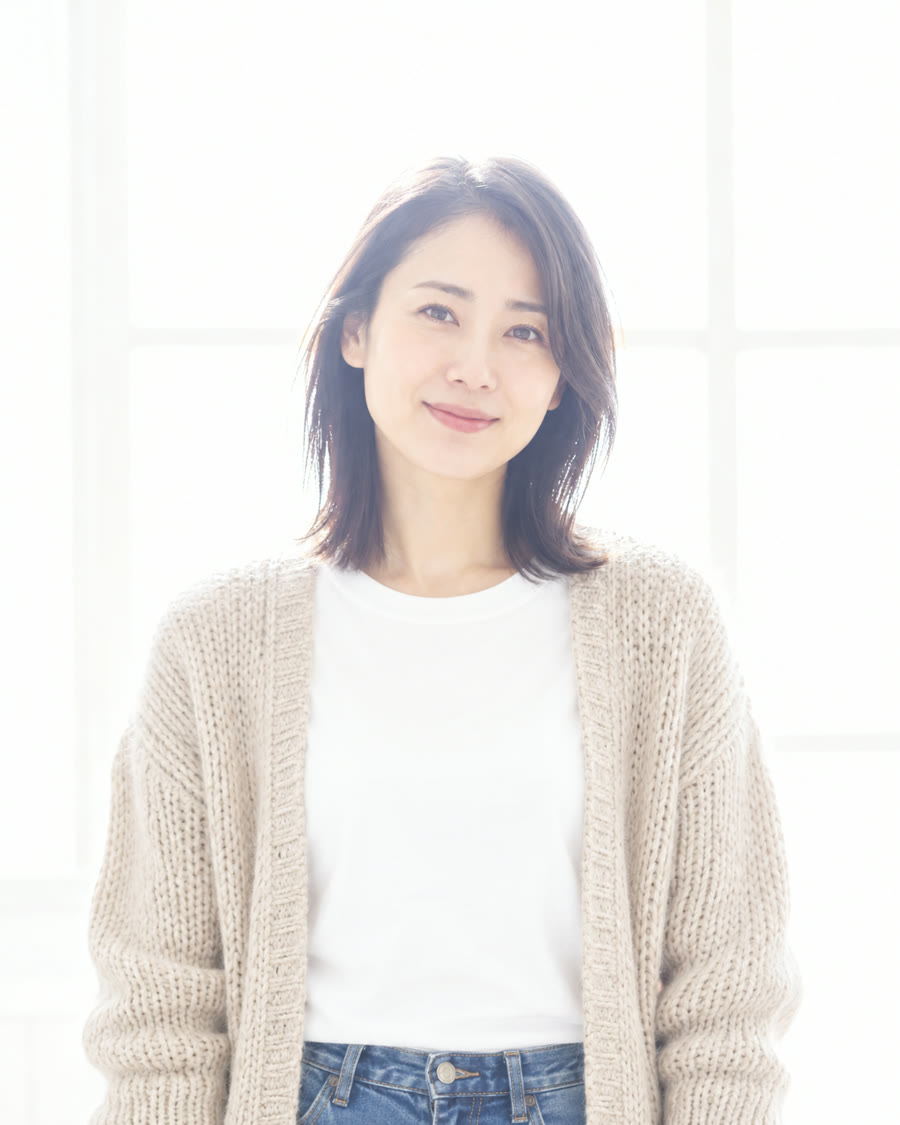
窓の光で撮った明るい室内の実写は 55.7% にとどまりました。ここから、合格の目安を変えています。「AI 画像が100% 本物と判定されること」ではなく、「実写と同じ割合で本物と判定されること」です。
30代はよく見分け、50代は見分けにくかった。道具の差は小さい
年代ごとの見分ける力(d′)
9人
35人
59人
30人
15人
d′ は 0 でまったく見分けられない、1 で「ある程度」。20代は9人と少ないので参考です。
30代は男女とも見分ける力が高く(d′ 0.76・0.78)、50代は男女とも低い結果でした(0.16)。架空のモデルの AI を本物と判定した割合は、30代 20.0%・50代 51.7%、女性 29.0%・男性 42.0% です。誰に向けたページかで、求められる本物らしさの水準が変わる可能性があります。
Codex と Google の Nano Banana は、ほぼ同じだった
実在の人を参照にした画像では、Codex 62.7%・Google 側 61.4% でした。同じカットを両方の道具で作った12組では、Codex が勝った組、Google 側が勝った組、同じくらいの組がそれぞれあります。差が大きい組は 74% 対 33% や 79% 対 50% まで開き、逆に架空のモデルでは Codex 37.5% 対 Nano Banana 70.4% という組もありました。道具の差より、1枚ごとの出来(顔・足元・背景)の差の方が大きいと読んでいます。
AI の目視の点検は、顔の判定で人と合った
Claude に画像を見せて、服の作り・靴・小物・手・顔の整いすぎを点検させる道具を作っています。この点検で「顔・肌が不合格」とした12枚は、人の判定で平均 35.7% しか本物と判定されませんでした。「合格」とした30枚は平均 60.0% です。顔の点検は、人の目とよく合っていました。
1か所の矛盾が、全体を AI に見せる
結果を読んで、私が大事だと考えたことを書きます。数字はここまでの章と同じものです。最初の読み取りには言い過ぎがあり、データと照らし合わせて8か所を直しました。それも合わせて残します。
1か所の矛盾が、全体を AI に見せる
試し回答をしたとき、人物はリアルなのに、シャンパングラスの液体だけが本物らしくない画像がありました。私のメモには「一箇所でもリアルではない部分があると、そこから全体に波及して」AI に見えると残しています。148人の結果でも、「その他」の記入74件のうち23件が足や靴で、背景にほかの人が写る AI は 26.2% まで下がりました。AI 画像づくりは、全体の質を上げる作業というより、矛盾を1つも残さない作業だと考えています。
違和感が引き金になって、顔を見に行く
私自身、靴がスニーカーとスリッパに分かれていることに気づいてから顔を見て、「綺麗すぎ・整いすぎているので AI か」と判断しました。違和感がなければ、気づかなかったかもしれません。「全体が整いすぎ」はほぼ AI と答えるときにだけ選ばれ、そのときは 74.2% 当たっています。顔の整いすぎは、疑われてから見つかる。引き金になる矛盾を消せば、顔まで見られずに済むのではないか、というのが私の仮説です(まだ確かめていません)。
参照にした画像の質が、そのまま受け継がれる
実写を参照にした AI は実写と同じくらい本物と判定され、実写の平均を超えた AI 17枚のうち16枚がそうでした。私は、AI 画像を参照にすると AI 感が残り、実写を参照にすると実写の質になる、と受け取っています。ただし、架空のモデルが低い理由が「参照が AI 画像だったから」か「顔が整いすぎていたから」かは、今回のデータでは分けられません。そこで次は、参照画像なしで写真に近い顔を作り、その顔を固定して同じ人を作る方法を試しています。
背景は、見抜かれる場所ではなく、疑われる場所
最初は「背景と人物のコントラスト」が最大の手がかりだと読んでいました。データでは、背景を決め手にした判定は 53.8% しか当たらず、実写を AI と間違えた理由の1位でした。見抜く手がかりは顔です。それでも、作る側としては背景から人物を浮かせない工夫に意味があります。その後に作った画像でも、私は「合成感」「人物が浮いて見える」と感じました。原因は、参照にした顔写真の光の向きや明るさが背景と違うこと、そして「画像を参照して」と「全体を統一して」という食い違う指示を同じ文に入れていたことだと見ています。
分かりきった欠点は、先に外してから試す
靴の誤りは、配信前から気づいていました。「ノイズになる部分はあらかじめ除外した上でテストしないと、分かりきった結果が出るだけで意味がありません」。次の回では、靴の不一致・背景のほかの人・文字が写る小物・大きな笑顔への偏り・強いぼかしを、配信前の点検で外します。
目指すのは「100% 本物」ではなく「実写と同じ」
実写でも4割近くは AI と判定されます。お客様が商品ページで見る写真も、同じ目で見られているはずです。AI 画像の合格の目安は、実写と同じ割合で本物と判定されることに置き直しました。
最初の読み取りから直した8か所
- 最初の読み取りデータで直した読み方
- AI と見分けるのは不可能条件の良い AI は見分けられないが、架空のモデル(34.5%)と明らかな AI(14.0%)は多くの人に見抜かれた
- 写真と判定されやすいのは室内室内ではなくスタジオ。AI ではスタジオ 59.1%・屋外 48.0%・室内 40.8%
- 最大の手がかりは背景とのコントラスト最大の手がかりは顔。背景は「疑われるきっかけ」にとどまる
- 実写以上に写真らしい AI がある82.7% 対 77.4% は誤差の範囲。「同じくらい」と読む
- 背景のぼかしは強いほど悪い強すぎても、くっきりしすぎても下がる。ちょうどよい範囲がある
- 特に30代の女性がよく見分ける30代は男女とも見分ける力が高い(d′ 0.76・0.78)
- 実写の平均を超えた AI は、参照を使わなかった画像逆で、17枚中16枚が実在の人の写真を参照にした画像
- 架空のモデルが低いのは、AI 画像を参照にしたから参照のせいか、顔の整いすぎのせいかは今回のデータでは分けられない
指示書の1語の誤りが、結果に出た
指示書に、靴を間違えて書いた
実物はかかとのないフラットな靴なのに、白いスニーカーと書いていました。カットごとに靴が変わり、私自身が試したときも、靴の違和感に気づいてから顔を見て AI と判定しました。いまは、参照する実写を拡大して確かめてから指示を書いています。
点検の基準も間違えていた
服の細部の形を、実物と違う基準で書いていたため、正しい画像まで不合格にしていました。点検の基準も、実物の写真で確かめてから書くようにしました。
一部分だけ直させるのは、2回とも失敗した
Codex に余分な部品を消すよう頼んでも残り、直すと別の場所が崩れました。崩れた画像は直さずに外すことにしました。
文字が写る小物は使えなかった
看板などは文字が崩れて、すぐ AI と見抜かれました。場面から外しています。
AI に比べさせた試しは、簡単な問題だった
16回とも当てたのは、私が一目で AI と分かるカットだったからです。最初は AI 画像だけ縦横比が違い、それだけで見分けがついていました。
Claude の予想は大きく外れた
実写を 85% と見込んでいました。「人は実写でも4割前後を AI と判定する」という前提が抜けていました。
いちばん大事な「売上が上がるか」は、まだ分からない
この調査で言えないこと
- 本物らしい AI 画像に替えると、売上や転換率が上がるか。今回分かったのは「本物の写真と判定されるか」までです。
- 回答者が、実際に買ってくださるお客様と同じ見え方をしているか。今回は 30〜50代が中心で、購入者の層との近さは確かめていません。
- 架空のモデルが低い理由。参照にしたのが AI 画像だったからか、顔が整いすぎていたからかは、今回のデータでは分けられません。
- 画像1枚ごとの差。1枚あたり約50人なので、1枚ごとの割合には ±15 ポイントほどの幅があります。
- 実写と AI で場面が違う組があること。画像の数値との相関には、場面の違いが混ざっています。
- 回答にかかった時間・見た端末・掲載順の影響。掲載順は組ごとに固定だったため、順番だけの効果は分けられません。
実在のモデルさんの顔を参照にした AI が強いことは分かりました。ただ、商品ページで使う場合の取り決めはまだ決めていません。今回の画像は、社内の分析とこの判定のためだけに使っています。
次にやること
- 架空のモデルでも、顔を整えすぎなければ実写並みになるのかを試す。参照画像を使わずに、場面を細かく書いた指示文だけで作ると、顔の写り方が変わった。窓辺で笑うスマホのスナップのような書き方が、いちばん写真らしく見えた
- 良い顔が出たら、それを基準にして同じ人を別の場面で作り、もう一度クラウドサービスで判定してもらう
- 背景のぼかしの強さを段階で比べ、ちょうどよい範囲を数字で決める
- AI の点検の合否と人の判定の一致を測り、点検の合格の範囲を決める
- 最後は、商品ページに出して売上で確かめる
数字の読み方
- 本物と判定された割合
- その画像を見た人のうち、「カメラで撮った写真」と答えた人の割合。実写なら高いほど正解、AI なら低いほど見抜かれている。
- 95%の幅
- 回答の数から計算した「本当の値がこの範囲にある見込み」。2つの幅が大きく重なるときは、差があるとは言わない。
- 決め手ごとの正解率
- その決め手を選んだ判定のうち、正解だった割合。
- 見分ける力(d′)
- 実写を写真と当てる割合と、AI を写真と誤る割合の差から計算する指標。答えの偏り(何でも「写真」と答える傾向)に左右されない。0 でまったく見分けられない。
- 判定の偏り(c)
- プラスは「写真」と答えやすい傾向。
- フライスのカッパ
- 同じ画像への答えが、人どうしでどれだけそろうか。0.2 以下は「わずかに一致」。
- 順位の相関
- 2つの数値の順位がどれだけそろうか(スピアマン)。−1〜+1。
- 二項検定
- 33問で偶然に当たる数を超えているかの検定。片側5%で判定した。
調査の条件
- 実施: 2026年10月。締めの時刻より後に届いた2件は集計に含めていない
- 回答の承認は照合せずにすべて行い、除外した2件は集計からだけ外した
- 画像の属性(構図・場所・背景の人・表情)は、Claude が一覧を目で見て付けた
- 画像の数値(明るさ・白とび・鮮明さの比など)は、画像から機械で計算した
- 実在のモデルさんの写真と、それを参照にした AI 画像は、社内の分析と今回の判定のためだけに使い、外には出していない
- このページの人物の写真は、説明のために Codex(ChatGPT の画像生成)で新しく作った架空の人物